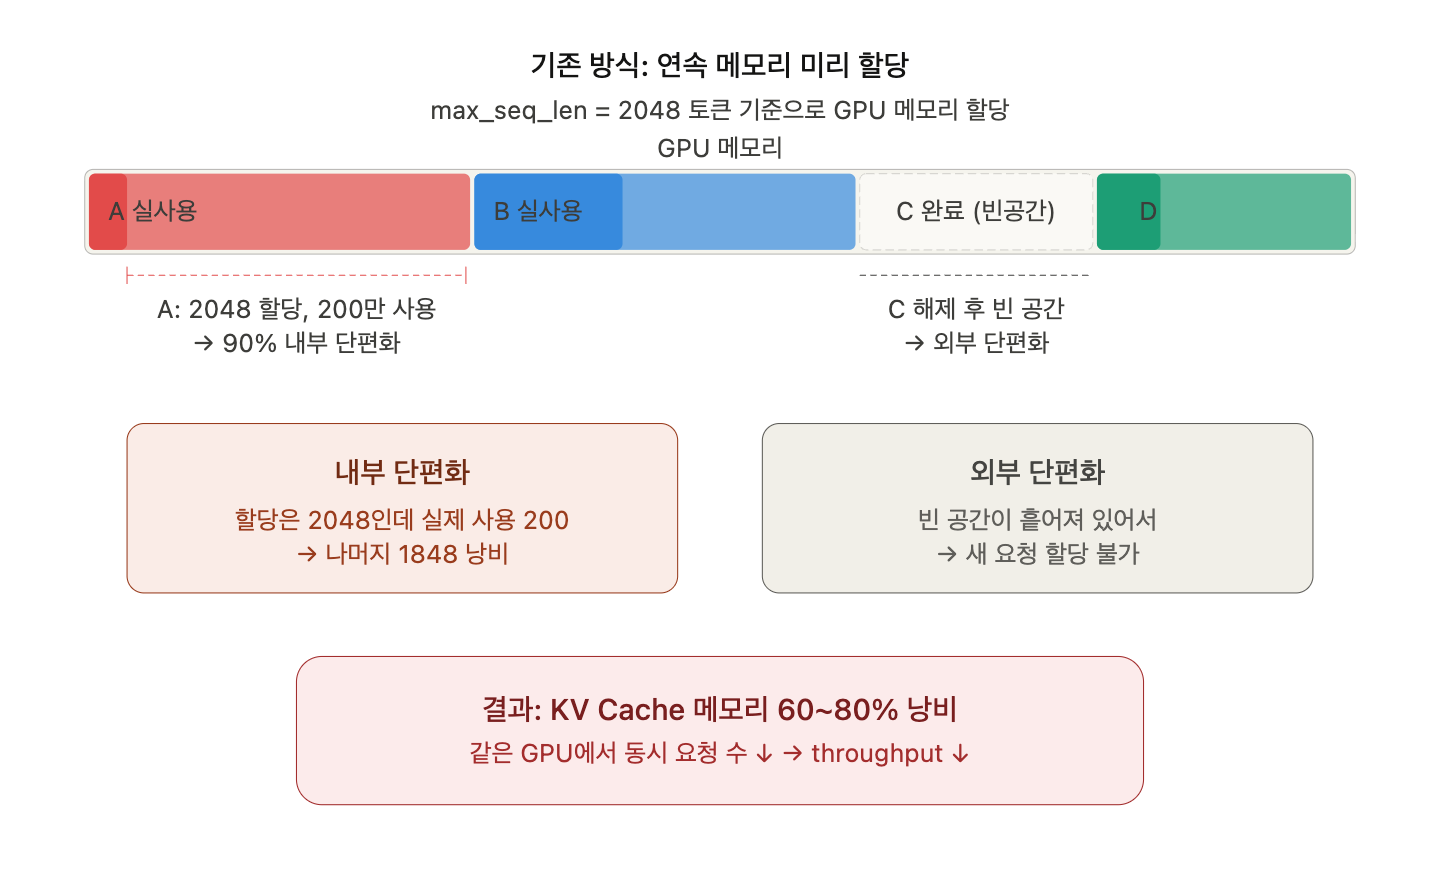
LLM 서빙 엔진이란?
학습이 끝난 LLM 모델을 실시간 추론 요청에 응답할 수 있도록 serving하는 런타임이다. 단순히 를 호출하는 것과 달리, 다수의 동시 요청을 높은 처리량(throughput)과 낮은 지연시간(latency)으로 처리하는 것이 핵심 목적이다. 왜 별도 엔진이 필요한...
5 posts
학습이 끝난 LLM 모델을 실시간 추론 요청에 응답할 수 있도록 serving하는 런타임이다. 단순히 를 호출하는 것과 달리, 다수의 동시 요청을 높은 처리량(throughput)과 낮은 지연시간(latency)으로 처리하는 것이 핵심 목적이다. 왜 별도 엔진이 필요한...
왜 로컬 STT가 필요했나 면접을 준비하면서 STAR 기법으로 답변을 작성하고, 실제로 소리 내어 말하는 연습을 하고 있었다. 문제는 녹음한 내 답변을 텍스트로 확인하고 싶을 때 생겼다. 클로바노트나 다글로 같은 SaaS STT 서비스를 쓸 수도 있었지만, 몇 가지 이...
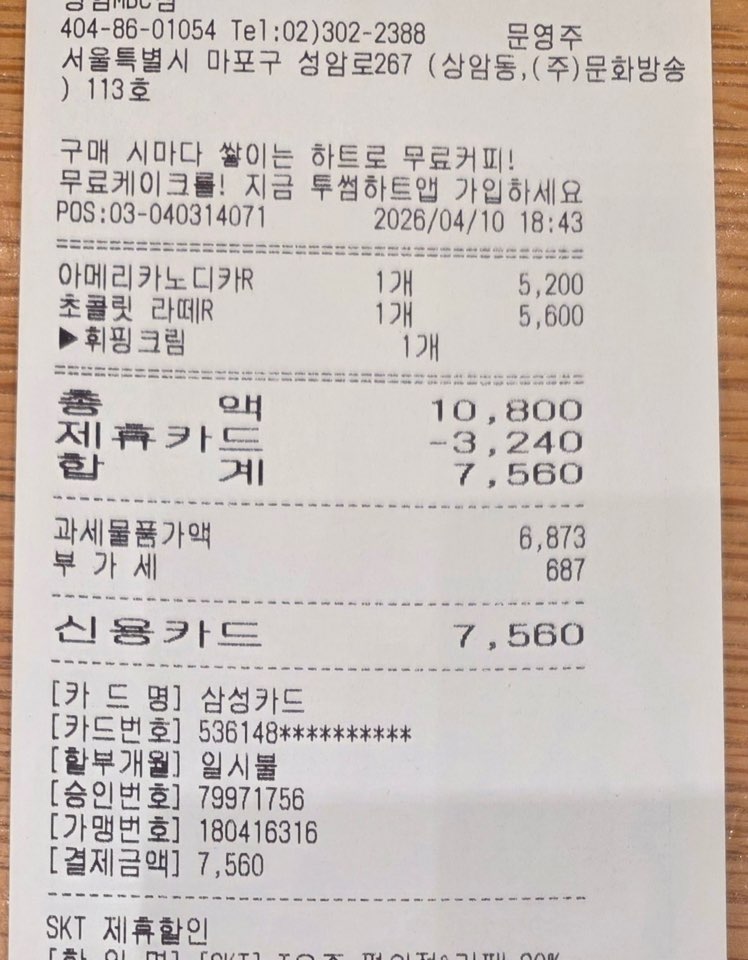
최근 로컬에서 돌릴 수 있는 Vision-Language(VL) 모델들이 빠르게 발전하면서, 내 맥북 한대에서 영수증 OCR을 완전히 로컬로 처리하는 것이 현실적인 선택지가 되었다. 특히 알리바바 모델인 Qwen3-VL-8B는 80억 파라미터의 멀티 모달 모델로, 이미...
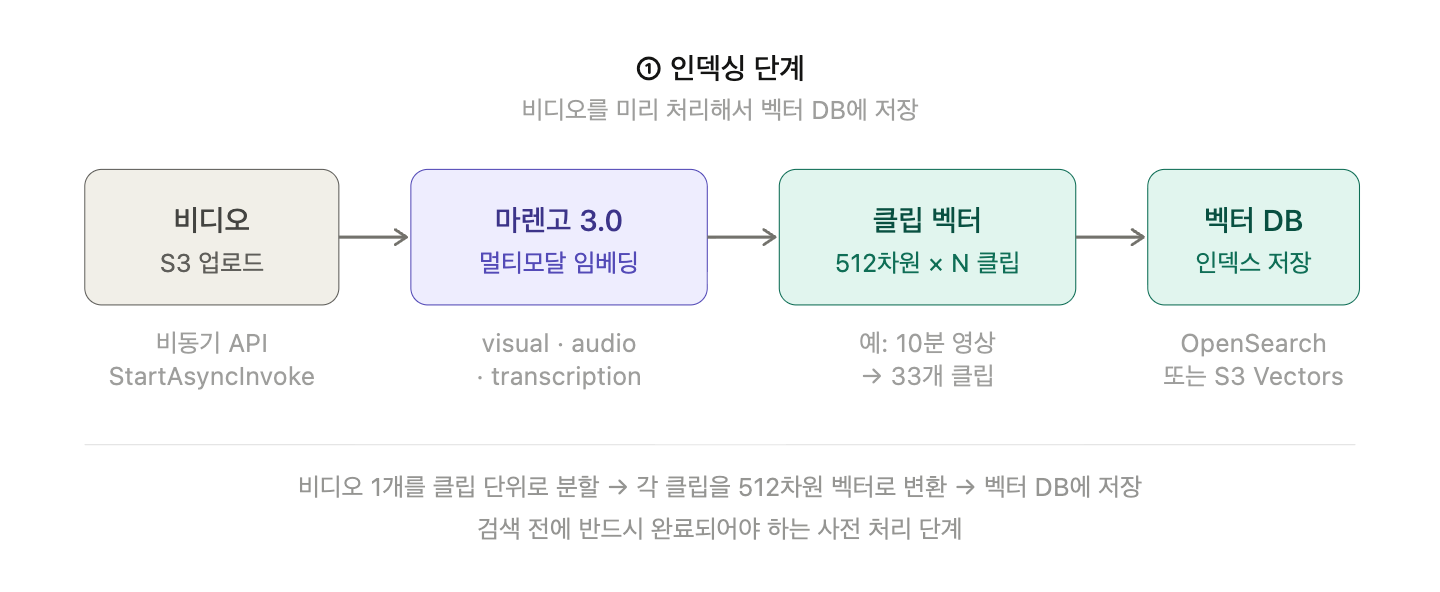
1. 왜 Video를 이해하는 AI모델이 필요한가? OTT, 숏폼, 라이브 스트리밍 등 플랫폼이 늘어나면서 제작되는 비디오 양이 폭발적으로 증가하고 있습니다. 이에 따라 현장에서는 세 가지 현실적인 문제가 생깁니다. - 플랫폼별 편집 및 재가공 시간 증가 - 검색과...
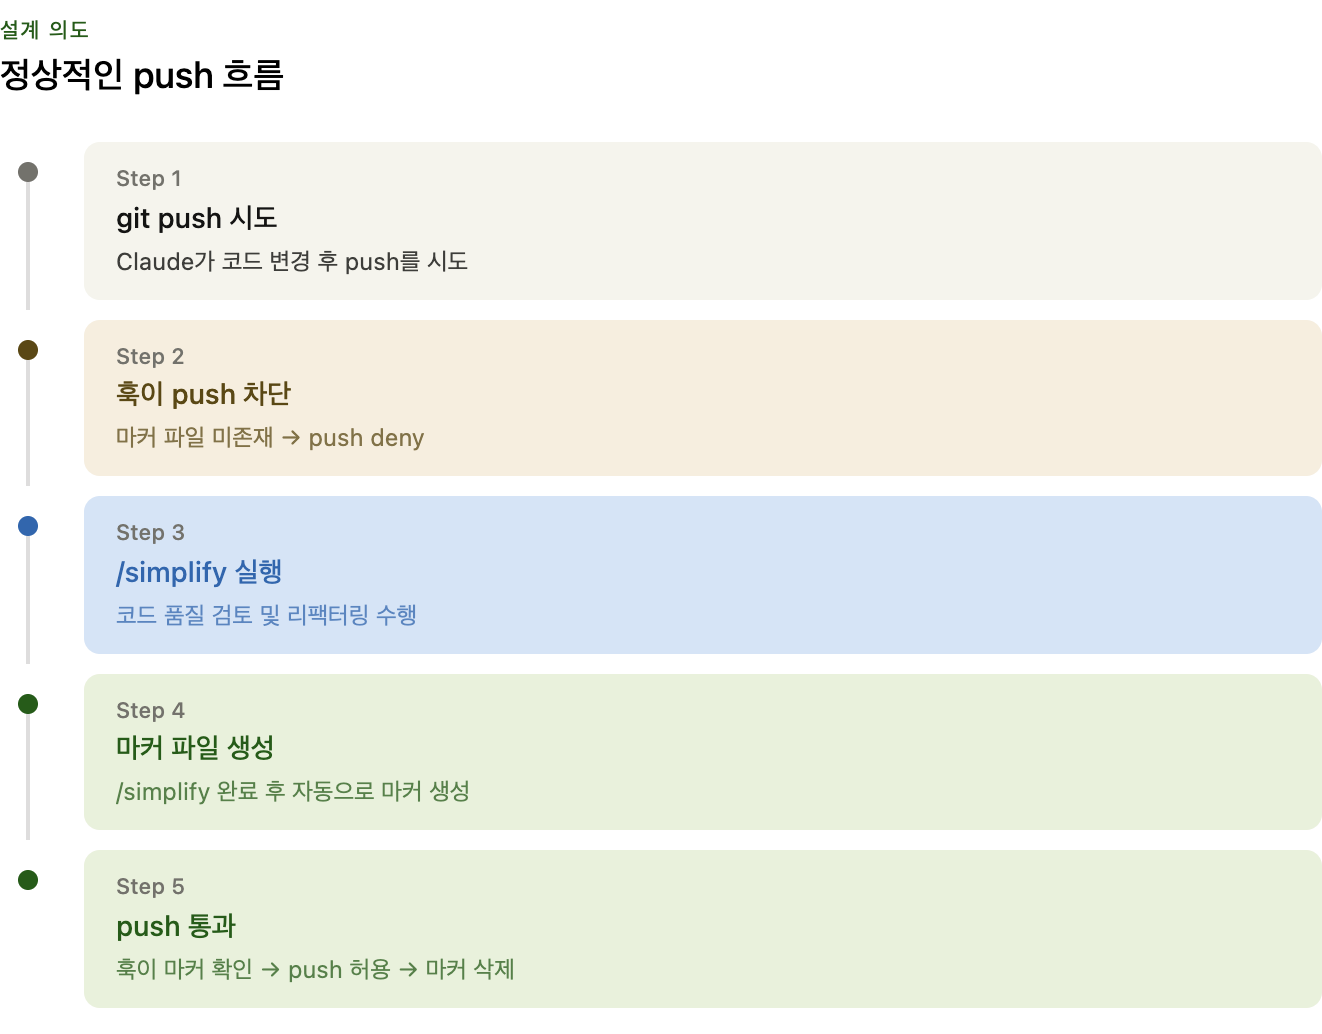
AS-IS → TO-BE AS-IS: 기존 훅 () > ❌ 문제: 에 명령어가 직접 노출되어 Claude가 없이 우회 가능 --- TO-BE: 수정된 훅 + 로컬 skill 1. 훅 메시지 수정 2. — Phase 4 추가 > ✅ 결과: 훅 메시지에 우회 방법 없...