최근 로컬에서 돌릴 수 있는 Vision-Language(VL) 모델들이 빠르게 발전하면서, 내 맥북 한대에서 영수증 OCR을 완전히 로컬로 처리하는 것이 현실적인 선택지가 되었다. 특히 알리바바 모델인 Qwen3-VL-8B는 80억 파라미터의 멀티 모달 모델로, 이미지를 입력받아서 텍스트를 생성 할 수 있는 모델이다.
그런데 이 모델을 로컬에서 돌리려면 양자화(Quantization)가 필수다. 원본 FP16은 약 16GB의 메모리를 차지하지만, Q4로 양자화하면 약 5GB로 줄어든다. 문제는 양자화를 할수록 각 파라미터의 정밀도가 떨어진다는 것이다. 가중치 0.0023456789가 Q4에서는 0.002 수준으로 반올림된다.
그래서 궁금했다. 한국어 영수증 OCR이라는 구체적인 태스크에서, 양자화 수준에 따라 실제 정확도 차이가 얼마나 발생하는가? Q4로 충분한가, 아니면 FP16까지 올려야 하는가? 속도와 메모리는 얼마나 차이 나는가?
이 글은 동일한 한국어 영수증 세트를 Qwen3-VL-8B의 세 가지 양자화 버전(Q4_K_M, Q8_0, FP16)으로 처리한 뒤, 필드별 정확도, 응답 속도, 메모리 사용량을 정량적으로 비교한 결과를 담고 있다.
테스트 환경
| 항목 | 사양 |
|---|---|
| 장비 | MacBook Air (2025) |
| 칩 | Apple M4, 10-core CPU / 10-core GPU / 16-core Neural Engine |
| 메모리 | 32GB 통합 메모리 (LPDDR5X, 120 GB/s 대역폭) |
| OS | macOS Sequoia |
| 추론 도구 | Ollama (최신 버전) |
| 모델 | Qwen3-VL-8B-Instruct |
테스트 대상 양자화 버전
| 태그 | 양자화 | 모델 크기 | 파라미터 정밀도 |
|---|---|---|---|
qwen3-vl:8b | Q4_K_M | ~5GB | 4bit (가장 거친 반올림) |
qwen3-vl:8b-instruct-q8_0 | Q8_0 | ~8.2GB | 8bit (중간) |
qwen3-vl:8b-instruct-fp16 | FP16 | ~16GB | 16bit (원본 정밀도) |
M4 Air의 통합 메모리 대역폭은 120 GB/s로, LLM 추론이 memory-bound 작업인 점을 고려하면 8B 모델을 돌리기에 충분한 대역폭이다. 32GB 메모리에서 FP16(~16GB)까지 올려도 시스템 메모리를 포함해 여유가 있다.
대상 모델
동일한 Qwen3-VL-8B-Instruct 모델의 양자화만 달리한 세 가지 버전을 비교한다. 모델 아키텍처, 학습 데이터, 파라미터 수(80억)는 완전히 동일하고, 유일한 변수는 각 파라미터를 몇 비트로 저장하느냐다.
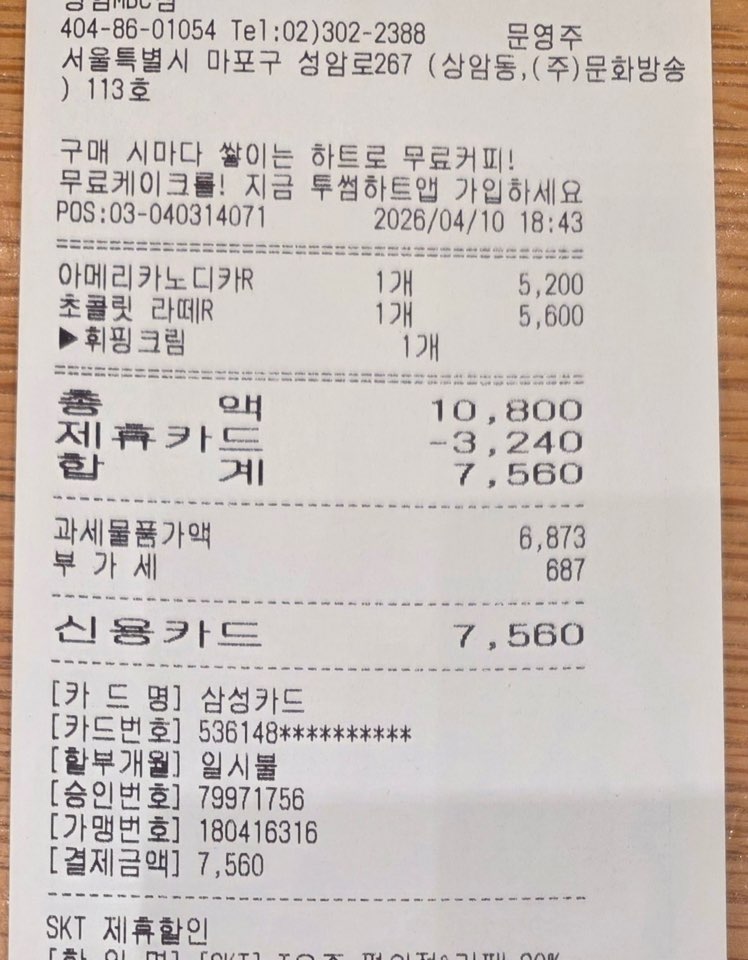
테스트 영수증
카페 영수증 1장을 사용한다. 카페 영수증을 선택한 이유는 한국어 OCR 난이도를 적절히 반영한다.
프롬프트
세 양자화 버전 모두 동일한 프롬프트를 사용한다.
이 영수증 이미지에서 아래 정보를 JSON 형식으로 추출해줘.
반드시 아래 형식을 지켜줘. 추가 설명 없이 JSON만 출력해.

{
  "store_name": "상호명",
  "date": "YYYY-MM-DD",
  "items": [
    {
      "name": "품목명",
      "quantity": 수량(숫자),
      "unit_price": 단가(숫자),
      "amount": 금액(숫자)
    }
  ],
  "total": 합계금액(숫자)
}
Thinking 모드는 비활성화한다(/nothink). OCR 추출에서 추론 과정이 불필요하게 토큰을 소모하여 속도 비교를 왜곡할 수 있기 때문이다.
평가 방식
모델이 출력한 JSON을 실제 영수증 내용(Ground Truth)과 육안 비교한다. 핵심 확인 포인트:
- 한글 상호명을 정확히 읽는가 (글자 빠짐, 오탈자 여부)
- 영한 혼용 메뉴명을 정확히 읽는가 (영문/한글 전환 부분에서 깨지는지)
- 금액 숫자가 정확한가 (자릿수 오류, 콤마 처리)
- 날짜 형식을 올바르게 파싱하는가
- JSON 형식을 지키는가 (파싱 가능한 유효 JSON인지)
통계적 비교가 목적이 아니라, 양자화 수준에 따라 한국어 인식 품질이 체감 가능한 수준으로 달라지는지를 확인하는 정성적 비교다.
측정 항목
| 측정 항목 | 측정 방법 | 단위 |
|---|---|---|
| 한국어 인식 정확도 | Ground Truth 대비 필드별 육안 비교 | 정확/부분 오류/완전 오류 |
| 응답 시간 | API 호출 시작~완료 elapsed time (3회 반복 중간값) | 초 |
| 메모리 사용량 | ollama ps 확인 | GB |
Comments
💬 Sign in with GitHub to leave a comment. Comments are public and stored in GitHub Discussions.