1. 왜 Video를 이해하는 AI모델이 필요한가?
OTT, 숏폼, 라이브 스트리밍 등 플랫폼이 늘어나면서 제작되는 비디오 양이 폭발적으로 증가하고 있습니다. 이에 따라 현장에서는 세 가지 현실적인 문제가 생깁니다.
- 플랫폼별 편집 및 재가공 시간 증가
- 검색과 분류를 위한 메타태깅 작업 부담
- 비디오 내용을 파악하는 분석 시간 증가
왜 비디오 분석은 오래 걸리나
비디오는 다른 데이터와 달리 두 가지 근본적인 어려움이 있습니다.
첫째, 데이터 양의 문제입니다. 10초짜리 짧은 영상도 30fps 기준으로 300장의 이미지로 구성됩니다. 영상이 길어질수록 처리해야 할 데이터가 선형적으로 늘어나며 메모리와 연산 시간에 근본적인 제약이 생깁니다.
둘째, 시간적 이해의 문제입니다. “컵을 들어올리는 장면”과 “컵을 내려놓는 장면”은 특정 프레임만 보면 구분이 불가능합니다. 시간 흐름에 따른 움직임의 맥락을 이해해야 합니다.
전통적인 방법의 한계
기존에는 태깅, 시스템 메타데이터, 자막 등 사람이 직접 입력하는 방식에 의존했습니다. 비디오 양이 적을 때는 가능했지만, 현재 규모에서는 현실적으로 불가능합니다.
분석 기술의 발전 방향
프레임 기반 분석
→ 개별 이미지를 분석, 시간적 맥락 이해 불가

샷 기반 분석
→ 장면 전환 단위로 분석, 일부 맥락 반영

멀티모달 임베딩 기반 분석 (마렌고)
→ 시각, 음성, 대사를 동시에 이해, 시간적 맥락까지 반영
2. 용어 및 개념정리
1. 임베딩 (Embedding)
- 데이터를 **의미가 보존된 숫자 배열(벡터)**로 변환하는 것
- 단순 벡터화와 차이점: 단순 벡터화는 의미 반영 없이 규칙으로 숫자 할당, 임베딩은 AI 모델이 학습을 통해 의미 관계를 숫자에 녹여냄
- 의미가 비슷할수록 벡터가 비슷하게 나옴
- 이미지 처리 전용이 아니라 텍스트, 추천 시스템, RAG 등 AI 전반에서 쓰이는 범용 개념
- “embed(심다)“에서 유래, 의미를 벡터 공간 안에 심는다는 뜻
2. 코사인 유사도
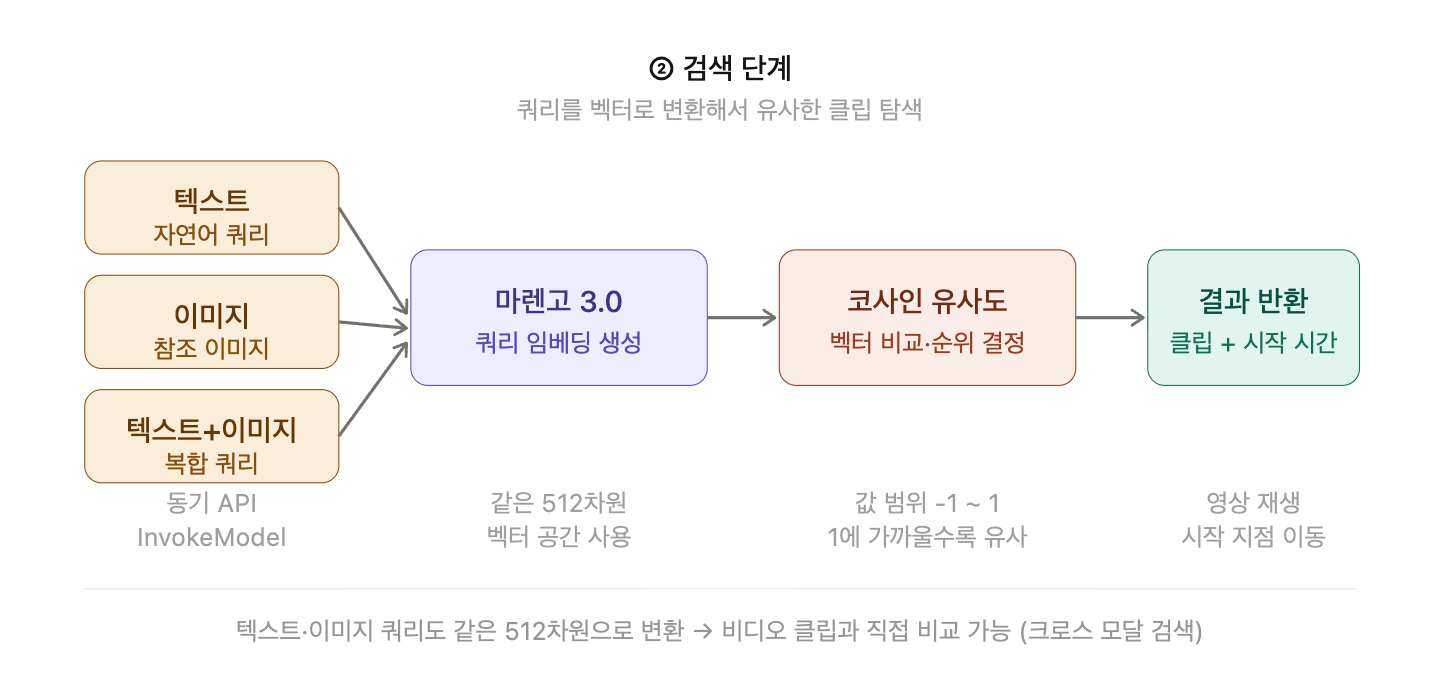
- 두 벡터가 얼마나 같은 방향을 가리키는지 측정
- 값 범위: -1 ~ 1 (1에 가까울수록 유사)
- 벡터 크기가 아닌 방향만 비교
- 비디오 검색의 핵심 원리: 쿼리 벡터와 클립 벡터들을 비교해서 가장 유사한 클립 반환
3. 마렌고 (Marengo)
- TwelveLabs의 임베딩 모델
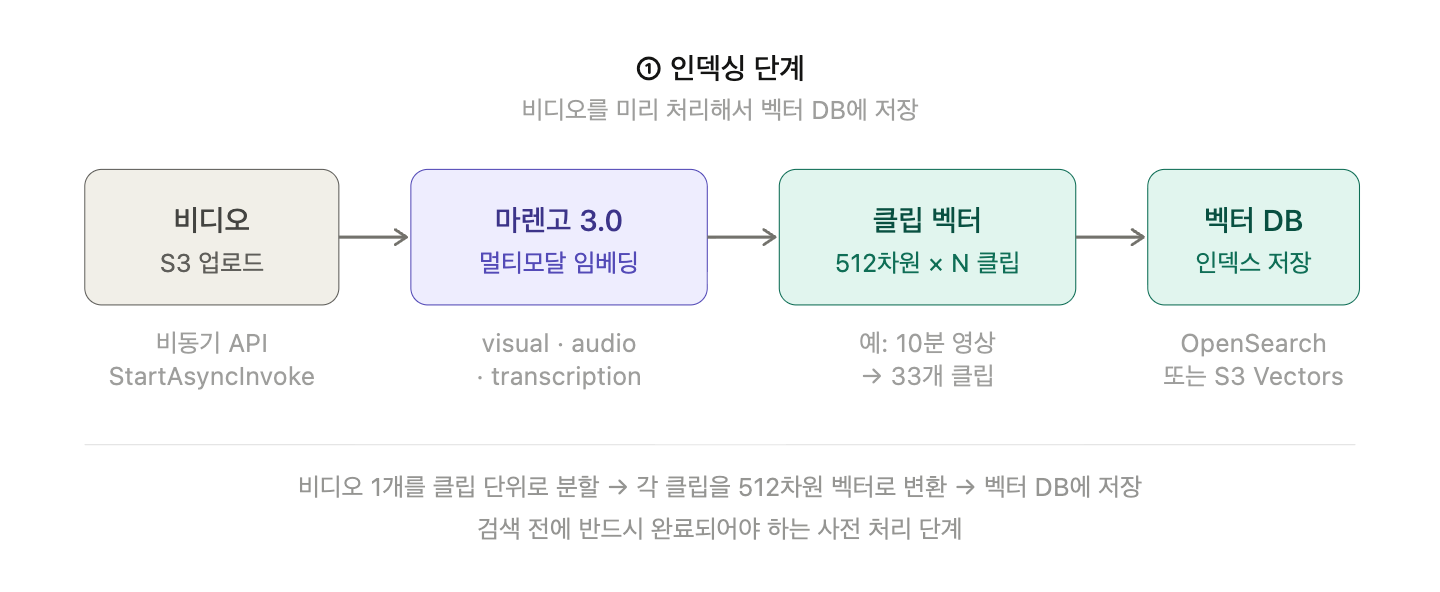
- 비디오를 클립 단위로 분할해서 각각 512차원 벡터로 변환
- 3가지 모달리티 임베딩 지원: visual, audio, transcription
- 입력 타입: 텍스트, 이미지, 텍스트+이미지 (동기 API), 비디오, 오디오 (비동기 API)
- 텍스트/이미지/비디오가 모두 같은 512차원 공간에 변환되어 크로스 모달 검색 가능
- 비디오를 생성하지 않음, 이해하는 모델
4. 페가수스 (Pegasus)
- TwelveLabs의 생성 모델
- 비디오를 보고 텍스트로 설명, 요약, 질의응답
- 벡터를 만들지 않아서 직접 검색은 불가
- 단, 페가수스가 생성한 텍스트를 마렌고로 임베딩하면 간접적으로 검색에 활용 가능
- 비디오를 생성하지 않음, 이해하는 모델
3. Video 검색부터 파이프라인까지
1. 검색 전략 3가지
배경: visual만 쓰면 대사나 소리 기반 쿼리에서 검색 품질이 떨어짐. 3개 모달리티를 어떻게 조합하느냐가 핵심.
Fused Embedding
- 3개 모달리티를 가중 평균으로 하나의 벡터로 합쳐서 저장
- 단순하고 빠르지만 가중치 변경 시 임베딩 전체 재생성 필요
- 어떤 모달리티가 결과에 기여했는지 알 수 없음
Multi-Vector Fixed Weights
- 3개 모달리티를 분리된 인덱스에 저장
- 검색 시 각각 검색 후 점수 합산
- 가중치를 코드에서 바꾸면 임베딩 재생성 없이 즉시 반영 (유연)
- 점수 합산 방법 2가지:
- Score Fusion: 점수에 가중치 곱해서 합산, 모달리티별 점수 범위가 다를 수 있음
- RRF: 점수 대신 순위 기반으로 합산, 점수 범위가 달라도 공정하게 결합, k=60 관례적 상수
- 여전히 가중치가 고정이라 쿼리마다 자동 조정 불가
Intent-based Dynamic Routing (= Dynamic Routing, 같은 말)
- 쿼리 의도를 분석해서 모달리티 가중치를 자동으로 동적 결정
- 사용자는 그냥 자연어로 요청, 시스템이 내부적으로 가중치 조정
- 가장 정교한 방식
2. VOD 파이프라인 (1-3)
- S3에 비디오 업로드 → EventBridge 감지 → Lambda 3개 병렬 실행
- 마렌고 Lambda: 임베딩 생성 (비동기)
- 페가수스 Lambda: 영상 요약 생성
- 메타데이터 Lambda: DynamoDB 저장
- 1-1에서 수동으로 했던 작업을 자동화한 이벤트 기반 서버리스 파이프라인
3. 모델 파편화 문제와 오케스트레이션
- 현실: 비디오 생성, 임베딩, 텍스트 생성, 음성 등 전문 모델이 계속 늘어남
- 두 방향이 공존: 전문화(성능 높지만 피로도 높음) vs 통합(편리하지만 성능 아직 부족)
- 해결 방향: 오케스트레이션 레이어
- 범용 모델(Claude 등)이 프롬프트를 분석해서 적절한 전문 모델을 동적으로 호출
- 사용자/개발자는 개별 모델을 직접 신경 쓰지 않아도 됨
- MCP: 모델 호출이 아니라 외부 툴/서비스(S3, Slack, DB 등) 연결을 표준화하는 인터페이스
- 모델 호출(Bedrock API)과 구분됨
Comments
💬 Sign in with GitHub to leave a comment. Comments are public and stored in GitHub Discussions.