학습이 끝난 LLM 모델을 실시간 추론 요청에 응답할 수 있도록 serving하는 런타임이다. 단순히 model.generate()를 호출하는 것과 달리, 다수의 동시 요청을 높은 처리량(throughput)과 낮은 지연시간(latency)으로 처리하는 것이 핵심 목적이다.
왜 별도 엔진이 필요한가? LLM은 autoregressive 특성상 토큰을 하나씩 순차 생성하는데, naive하게 구현하면 GPU 활용률이 극도로 낮다. 요청 A가 토큰 생성 중일 때 GPU가 놀고 있는 시간이 많기 때문이다. 서빙 엔진은 이 문제를 해결하는 최적화 기법들의 집합체다.
4가지 주요 개념
1. KV Cache
Transformer의 attention 계산에서, 이전 토큰들의 Key/Value 텐서를 매번 재계산하지 않고 메모리에 캐싱해두는 기법이다. 토큰이 길어질수록 재계산 비용이 제곱으로 늘어나기 때문에 KV Cache 없이는 실용적 서빙이 불가능하다. 다만 긴 시퀀스에서는 KV Cache 자체가 GPU 메모리의 대부분을 차지하게 되는데, 이 메모리 관리가 서빙 엔진의 핵심 차별점이 된다.
2. Continuous Batching
전통적 batching은 배치 내 모든 요청이 끝날 때까지 기다린다 (static batching). 요청마다 출력 길이가 다르므로, 짧은 응답이 끝나도 긴 응답을 기다리며 GPU가 낭비된다. Continuous batching은 완료된 요청을 즉시 빼고 대기 중인 새 요청을 바로 투입한다. 이것만으로 throughput이 수배 이상 올라간다.
3. PagedAttention (vLLM의 핵심 기여)
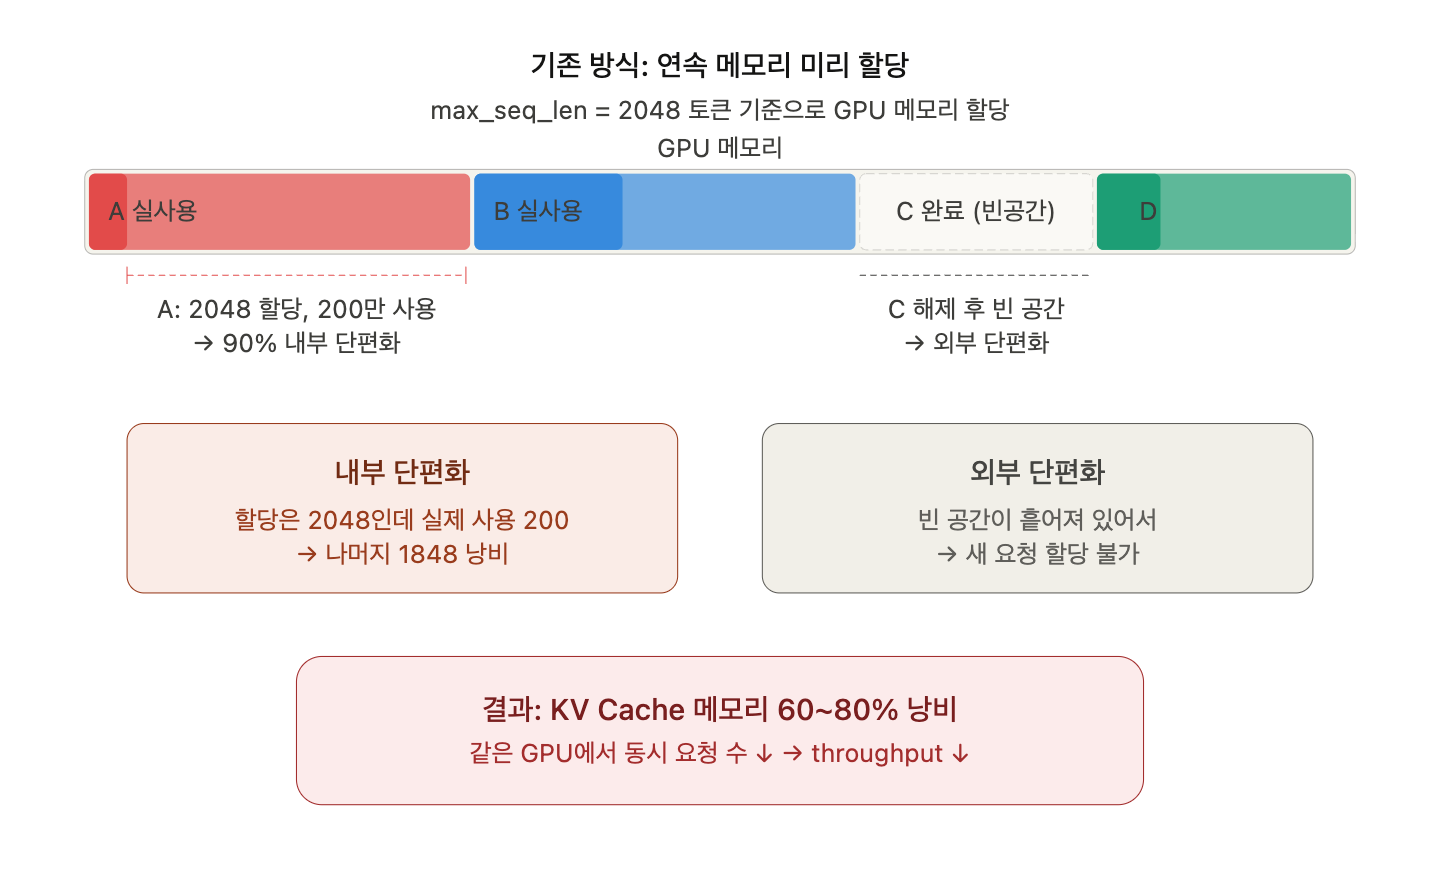
KV Cache 메모리를 OS의 virtual memory처럼 고정 크기 page 단위로 관리하는 기법이다. 기존에는 요청마다 최대 시퀀스 길이만큼 연속 메모리를 미리 할당해야 했는데, 실제로는 그보다 훨씬 적게 쓰므로 내부 단편화(fragmentation)가 심했다. PagedAttention은 필요할 때마다 page를 동적 할당하므로 메모리 낭비를 크게 줄이고, 같은 GPU 메모리에서 더 많은 동시 요청을 처리할 수 있다. vLLM 논문(2023, UC Berkeley)에서 제안되었고, 이 기법이 vLLM이 주류가 된 핵심 이유다.
PagedAttention 기법이 필요한 이유는 내부 단편화 때문이다.
4. Speculative Decoding
작은 draft 모델이 먼저 여러 토큰을 빠르게 생성하고, 큰 target 모델이 이를 한 번에 검증하는 방식이다. 검증 과정에서 맞는 토큰은 그대로 채택하고, 틀린 지점부터 다시 생성한다. LLM 추론이 memory-bound(연산보다 메모리 접근이 병목)인 특성을 활용한 것으로, throughput은 유지하면서 latency를 줄일 수 있다.
Comments
💬 Sign in with GitHub to leave a comment. Comments are public and stored in GitHub Discussions.