1. 출발점: 쿠버네티스의 핵심 동작 (Starting point)
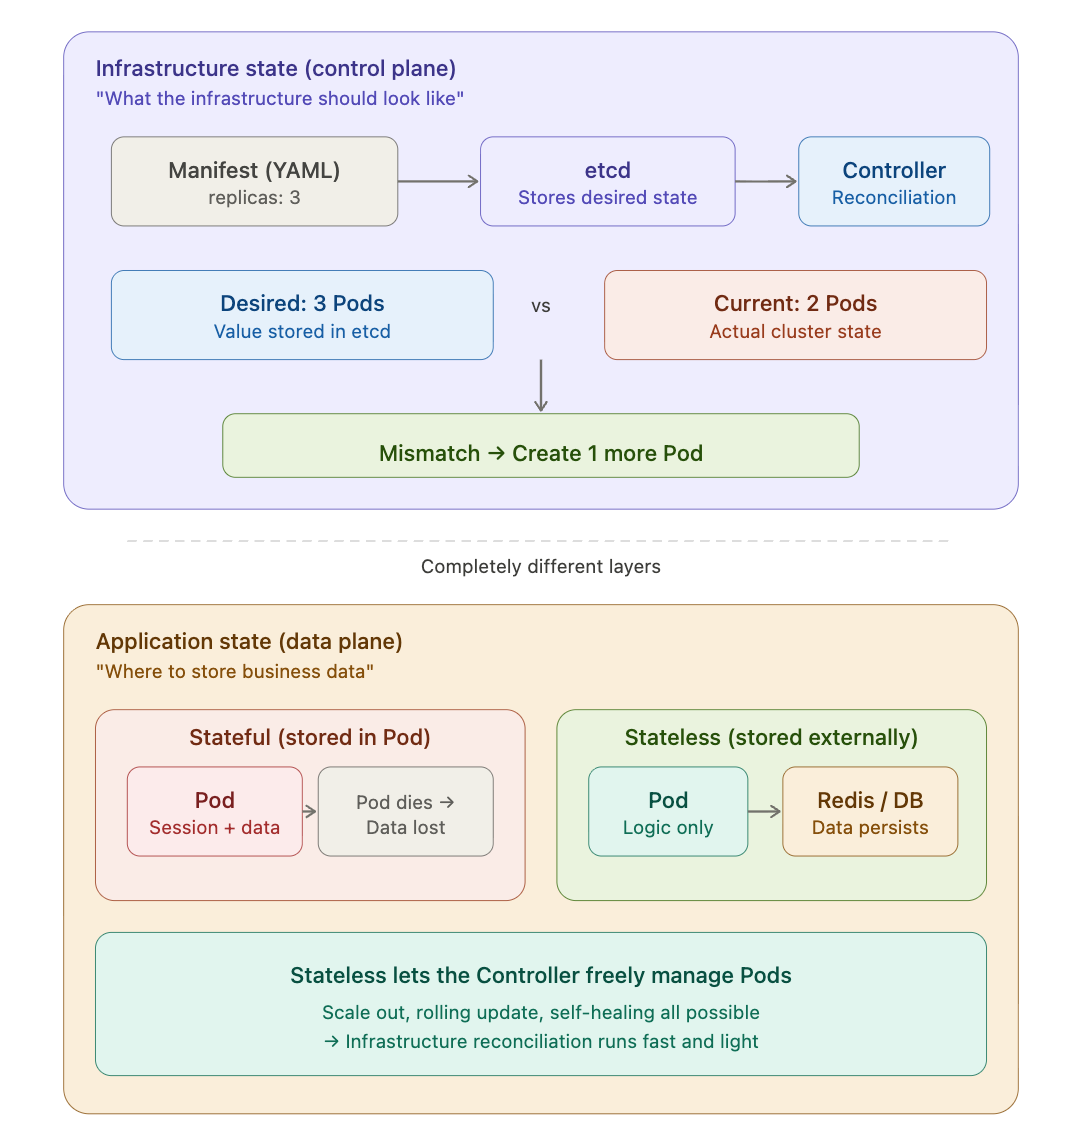
쿠버네티스는 오케스트레이션 엔진이다. 핵심 동작은 선언적 모델 — 사용자가 매니페스트(YAML)에 “이런 상태가 되어야 한다”고 선언하면, 시스템이 알아서 맞춰준다.
이 선언은 kubectl apply를 통해 API Server → etcd에 저장된다. 이게 desired state다. Controller는 이 값과 실제 current state를 계속 비교해서, 다르면 자동으로 일치시킨다. 이 반복을 reconciliation loop라고 부른다.
이 루프가 빠르고 가볍게 돌아가려면, Pod을 자유롭게 죽이고 늘리고 교체할 수 있어야 한다. 여기서 Stateless 설계의 필요성이 나온다.
쿠버네티스 철학: Pod은 언제든 죽을 수 있다 (Cattle, not Pets)
2. 왜 Stateless가 필요한가 (Why Stateless)
Pod 안에 세션이나 주문 데이터 같은 비즈니스 데이터가 있으면, 그 Pod을 함부로 죽일 수 없다. 죽이면 데이터가 날아가고, 스케일 아웃을 해도 새 Pod에는 기존 데이터가 없어서 sticky session이 필요하다.
해결책은 비즈니스 데이터를 Pod 밖으로 빼는 것이다. Redis, DB, S3 같은 외부 저장소에 맡기면 Pod은 요청을 처리하기만 하고, 아무것도 “기억”하지 않는다. 이런 Pod이 Stateless다.
이건 상태를 없애는 게 아니라, 상태를 관리할 책임을 전문가에게 넘기는 책임 분리(Separation of Concerns)다.
3. Stateless vs Stateful 비교 (Comparison)
| Stateless (무상태) | Stateful (상태 유지) | |
|---|---|---|
| 정의 (Definition) | 상태를 다루기만 하고 저장 안 함 | 상태를 저장하고 영속적으로 유지 |
| K8s 리소스 (Resource) | Deployment | StatefulSet |
| Pod 교체 (Replacement) | 자유로움. 죽으면 새로 띄우면 끝 | 같은 이름, 같은 볼륨 유지 필요 |
| 스케일링 (Scaling) | HPA로 자유롭게 오토스케일링 | 데이터 동기화, 멤버십 조정 필요 |
| 롤링 업데이트 (Rolling update) | 무중단 배포 가능 | 데이터 호환성 확인 필요 |
| 비중 (Proportion) | 전체 워크로드의 80~90% | DB, 캐시, 메시지 큐 등 데이터 계층 |
| 예시 (Examples) | API 서버, 웹 프론트엔드, 워커 | PostgreSQL, Kafka, Redis, Harbor |
4. StatefulSet이 Deployment와 다른 점 (StatefulSet specifics)
Stateful 워크로드는 왜 Deployment로 안 되는가? 데이터 정합성과 클러스터 멤버십을 보장해야 하기 때문이다. StatefulSet은 이를 위해 네 가지를 추가로 제공한다:
| 항목 | Deployment | StatefulSet |
|---|---|---|
| Pod 이름 (Pod name) | 랜덤 suffix (app-7f8b9c-xk2z) | 순번 고정 (db-0, db-1) |
| Volume 연결 (Volume binding) | Pod과 느슨한 연결 | volumeClaimTemplates로 Pod별 전용 PVC |
| 생성/삭제 순서 (Ordering) | 순서 보장 없음 | 0→1→2 순서 생성, 역순 삭제 |
| 네트워크 ID | 없음 | Headless Service로 고유 DNS |
5. 환경에 따른 설계 패턴 (Patterns by environment)
Stateful 워크로드를 어떻게 처리하느냐는 환경에 따라 달라진다.
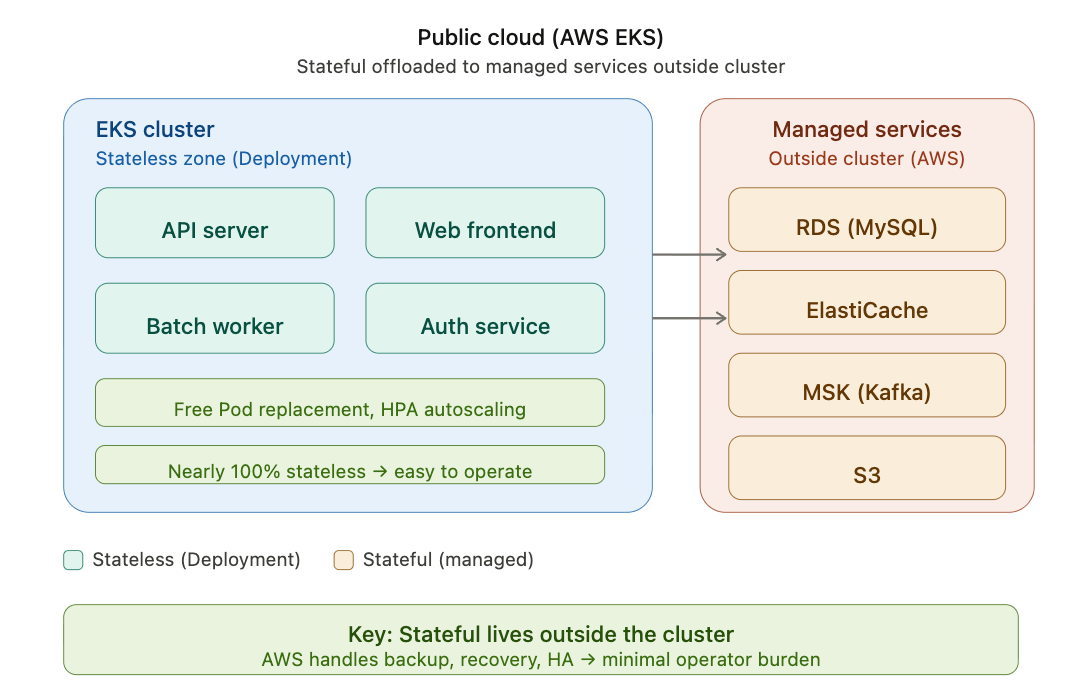
퍼블릭 클라우드 (EKS 등) — Stateful 워크로드를 매니지드 서비스(RDS, ElastiCache, MSK)로 클러스터 밖으로 분리. 클러스터 안은 거의 100% Stateless → 운영이 가장 편하다.
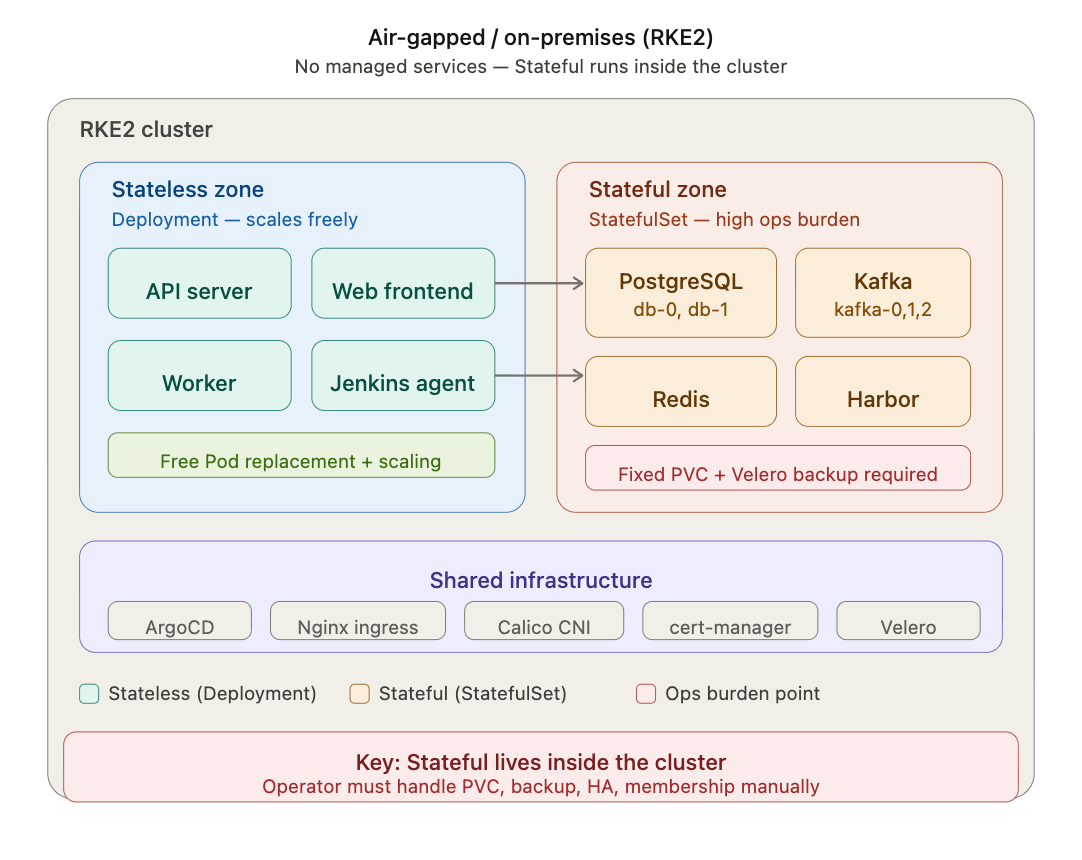
폐쇄망 / 온프레미스 (RKE2 등) — 매니지드 서비스 사용 불가. DB, Kafka, Harbor를 StatefulSet으로 클러스터 안에서 직접 운영 → PVC 관리, Velero 백업 등 운영 부담 증가.
6. 혼동 주의: “상태”의 두 가지 의미 (Two meanings of “State”)
같은 “상태”라는 단어가 두 레이어에서 쓰인다. 이 둘은 완전히 다른 이야기다.
| 인프라 상태 (Infrastructure State) | 애플리케이션 상태 (Application State) | |
|---|---|---|
| 무엇 (What) | 인프라 설계도 (replicas, image, port) | 비즈니스 데이터 (세션, DB, 캐시) |
| 저장 위치 (Where) | etcd | Pod 내부 or 외부 저장소 |
| 관리 주체 (Who) | 쿠버네티스 컨트롤 플레인 | 개발자의 아키텍처 설계 |
| 관련 개념 (Concept) | Reconciliation loop | Stateless / Stateful 설계 |
두 레이어가 만나는 지점: 애플리케이션 상태를 Pod 밖으로 빼야(Stateless) → Pod이 소모품이 되고 → 인프라 상태의 reconciliation loop가 빠르게 동작한다.
7. etcd: 인프라 상태의 저장소 (etcd)
위에서 말한 desired state가 실제로 저장되는 곳이 etcd다.
- 쿠버네티스의 유일한 데이터 저장소 (Single Source of Truth)
- 모든 리소스가
/registry/{type}/{namespace}/{name}형태의 key-value로 저장 - 오직 API Server만 etcd와 통신 가능. Controller, Scheduler, kubelet은 API Server의 watch event를 통해 변경사항 수신
- Raft consensus 기반 분산 저장소 → 프로덕션에서는 3대 이상 HA 구성
- etcd가 죽으면 클러스터 전체가 먹통 → etcd 백업 필수
데이터 흐름 (Data flow)
kubectl apply → API Server (인증/인가/Admission) → etcd 저장 → watch event → Controller가 desired ≠ current 감지 → Pod 생성/삭제 → Scheduler가 노드 배치 → kubelet이 컨테이너 실행
Comments
💬 Sign in with GitHub to leave a comment. Comments are public and stored in GitHub Discussions.