1. 컨트롤러가 왜 필요한가?
쿠버네티스는 선언적(Declarative) 시스템이다. 사용자는 “nginx 3개를 띄워줘”라고 **원하는 상태(Desired State)**만 선언하고, 어떻게 할지는 말하지 않는다.
API Server는 이 Desired State를 etcd에 저장하지만, 실제로 Current State를 Desired State에 맞추는 일은 하지 않는다.
💡 컨트롤러 = Desired State와 Current State 사이의 간극(gap)을 메우는 주체
왜 이런 구조인가? (인과적 추론)
- 원인: 분산 시스템에서는 노드가 죽고, 네트워크가 끊기고, Pod가 갑자기 사라질 수 있다. 현재 상태는 항상 불안정하다.
- 결과: “한 번 명령 → 끝”이 아니라, 지속적으로 감시하면서 차이가 생길 때마다 자동으로 복원하는 구조가 필요하다.
- 비유: 에어컨 온도 조절기(thermostat). “25도”로 설정하면, 현재 온도를 계속 측정하고 목표와 차이가 나면 냉방/난방을 켜는 것과 같다.
2. Reconciliation Loop (Control Loop)
컨트롤러의 핵심 동작 원리:
1. 현재 상태(Current State) 관찰 → "지금 nginx Pod가 2개 떠 있네" 2. 원하는 상태(Desired State) 확인 → "etcd에는 3개라고 적혀 있네" 3. 차이(Diff) 계산 → "1개가 부족하네" 4. 조정(Reconcile) 실행 → "Pod 1개를 더 생성하자"
이 루프를 Reconciliation Loop 또는 Control Loop이라 부른다.
3. 변화 감지 방식: Watch와 Informer
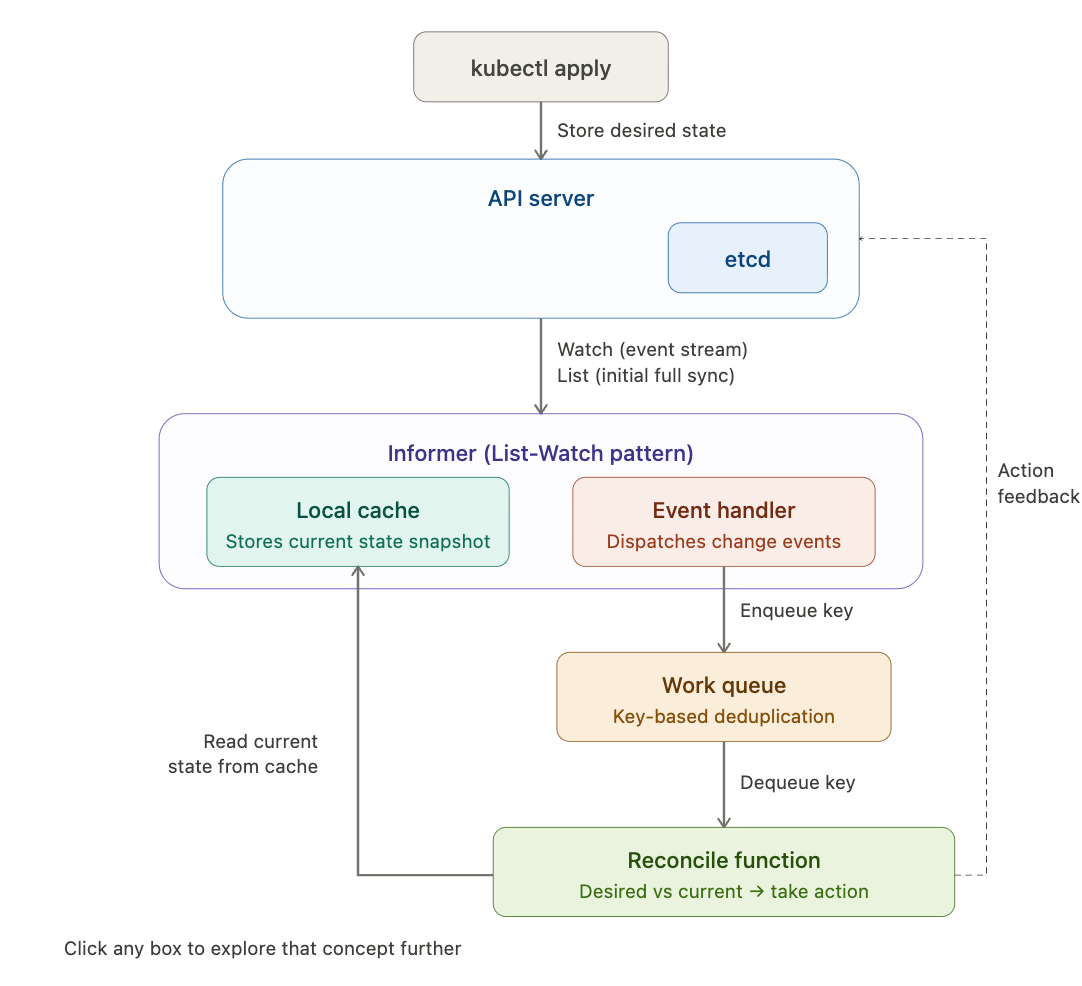
3-1. Polling vs Event-driven
컨트롤러가 “현재 상태가 변했는지”를 알아내는 방법은 두 가지:
| 방식 | 설명 | 문제점 |
|---|---|---|
| Polling | 주기적으로 API Server에 “지금 상태 알려줘” 요청 | 컨트롤러 수 × 리소스 수 = API Server 과부하 |
| Watch (Event-driven) | API Server와 long-lived 연결을 맺고, 변경 시 이벤트를 push 받음 | 연결 끊기면 이벤트 유실 |
- 쿠버네티스의 선택: Watch (Event-driven)
- 이유: 변경이 없으면 트래픽도 없음. API Server 부하가 리소스 수가 아닌 변경 빈도에 비례하므로 대규모 클러스터에서도 안정적.
3-2. Informer = List-Watch + 로컬 캐시
Watch만으로는 부족한 문제가 두 가지 있다:
| 문제 | 해결 방법 |
|---|---|
| Watch 연결 끊김 → 이벤트 유실 | List-Watch 패턴: 처음에 List로 전체 스냅샷 가져오고, 이후 Watch. 끊기면 다시 List부터 재동기화 |
| 여러 컨트롤러가 API Server에 동시 조회 → 부하 | 로컬 캐시: Informer가 데이터를 로컬에 저장. 컨트롤러는 API Server가 아닌 캐시에서 읽음 |
💡 Informer = List-Watch + 로컬 캐시를 묶어놓은 구조
3-3. Work Queue (Informer와 별도 구조)
Informer 밖에 붙는 별도 구조. 이벤트 처리의 정합성 문제를 해결한다.
Work Queue가 필요한 이유 (예시): 1초 안에 이벤트 3개 수신: “Pod-A 삭제됨” → “Pod-B 삭제됨” → “Pod-A 생성됨”
- 이벤트마다 바로 Reconcile을 호출하면 → 삭제 이벤트에 반응해서 Pod를 추가로 만들었는데, 직후에 자동 재시작으로 돌아옴 → 의도보다 Pod가 많아지는 정합성 문제 발생.
Work Queue의 해결 방식:
- 이벤트 자체가 아니라 오브젝트 키(예:
default/Pod-A)를 큐에 넣음 - 같은 키가 이미 있으면 중복 제거(dedup)
- Reconcile은 큐에서 키를 꺼내서, 그 시점의 최신 로컬 캐시를 보고 판단
SQS와의 차이:
- SQS는 메시지가 영속적(persistent). Consumer가 죽어도 큐에 남음.
- K8s Work Queue는 인메모리. 컨트롤러가 죽으면 큐도 날아감.
- 컨트롤러 재시작 시 안정성은 Informer의 List가 보장 (전체 재동기화).
3-4. 컴포넌트별 역할 요약
| 컴포넌트 | 해결하는 문제 | 핵심 메커니즘 |
|---|---|---|
| List-Watch (Informer 내부) | Watch 끊김 시 이벤트 유실 | 끊기면 List로 전체 재동기화 |
| 로컬 캐시 (Informer 내부) | API Server 조회 부하 | 캐시에서 읽기 |
| Work Queue (Informer 외부) | 이벤트 중복, 정합성 | 키 기반 중복 제거 + 최신 캐시 기준 판단 |
| Reconcile 함수 | 실제 gap 해소 | desired vs current 비교 → 액션 실행 |
4. 전체 흐름
kubectl apply (desired state)
        │
        ▼
   API Server ──── etcd (desired state 저장)
        │
        │  List (최초 전체 동기화)
        │  Watch (이후 변경 이벤트 스트림)
        ▼
    Informer
        │
        ├──→ Local Cache (현재 상태 스냅샷, 컨트롤러가 여기서 조회)
        │
        └──→ Event Handler ──→ Work Queue (키 기반 중복 제거)
                                     │
                                     │  키 dequeue
                                     ▼
                              Reconcile 함수
                         (캐시에서 current 조회 →
                          desired와 비교 → 액션 실행)
5. Informer는 어디에 떠있는가?
Informer는 별도 프로세스나 Pod가 아니다. 각 컨트롤러 코드 안에 내장된 라이브러리(client-go의 일부)이다.
[컨트롤 플레인 노드]
  └─ kube-controller-manager (하나의 프로세스)
       ├─ Deployment Controller
       │    └─ Informer (Deployment 리소스 Watch)
       ├─ ReplicaSet Controller
       │    └─ Informer (ReplicaSet 리소스 Watch)
       ├─ Node Controller
       │    └─ Informer (Node 리소스 Watch)
       └─ ...
kube-controller-manager 안에서 여러 컨트롤러가 **고루틴(goroutine)**으로 돌아가고, 각 컨트롤러마다 전용 Informer를 가진다.
6. Deployment Controller와 ReplicaSet Controller의 분리
6-1. 오브젝트 체인
Deployment → ReplicaSet → Pod
Deployment가 Pod를 직접 만들지 않고, 중간에 ReplicaSet을 둔다.
6-2. 왜 분리하는가? (인과적 추론)
만약 Deployment Controller가 직접 Pod를 관리했다면? 롤링 업데이트 시 “이 Pod는 v1인가 v2인가?”, “v1을 몇 개까지 줄여도 되나?”, “롤백하면 어떤 Pod를 살려야 하나?” — 이 모든 로직이 한 곳에 뒤섞인다.
분리하면?
| 컨트롤러 | 역할 | 특징 |
|---|---|---|
| Deployment Controller (전략가) | ReplicaSet을 만들고 replicas 숫자를 조정 | Pod를 직접 안 건드림. 롤링/롤백 전략을 알고 있음 |
| ReplicaSet Controller (실행자) | 자기한테 주어진 replicas 수에 맞게 Pod 생성/삭제 | 롤링 업데이트가 뭔지 모름. “3개 유지해”하면 3개 맞춤 |
💡 이것이 쿠버네티스의 단일 책임(Single Responsibility) 원칙 — 계층적 컨트롤러 패턴
Comments
💬 Sign in with GitHub to leave a comment. Comments are public and stored in GitHub Discussions.